跨维智能发布全球首个机器人任务原生3D世界模型
机器人如何理解物理世界?大语言模型依靠“文本”这一统一空间实现知识学习与迁移,而具身智能面对的是更加复杂的物理环境,即视觉、动作、物体运动与环境变化长期缺少统一表达方式。10月12日,深圳企业跨维智能发布全球首个机器人任务原生3D世界模型UNITAS,探索为Physical AI建立统一表示空间的新路径。
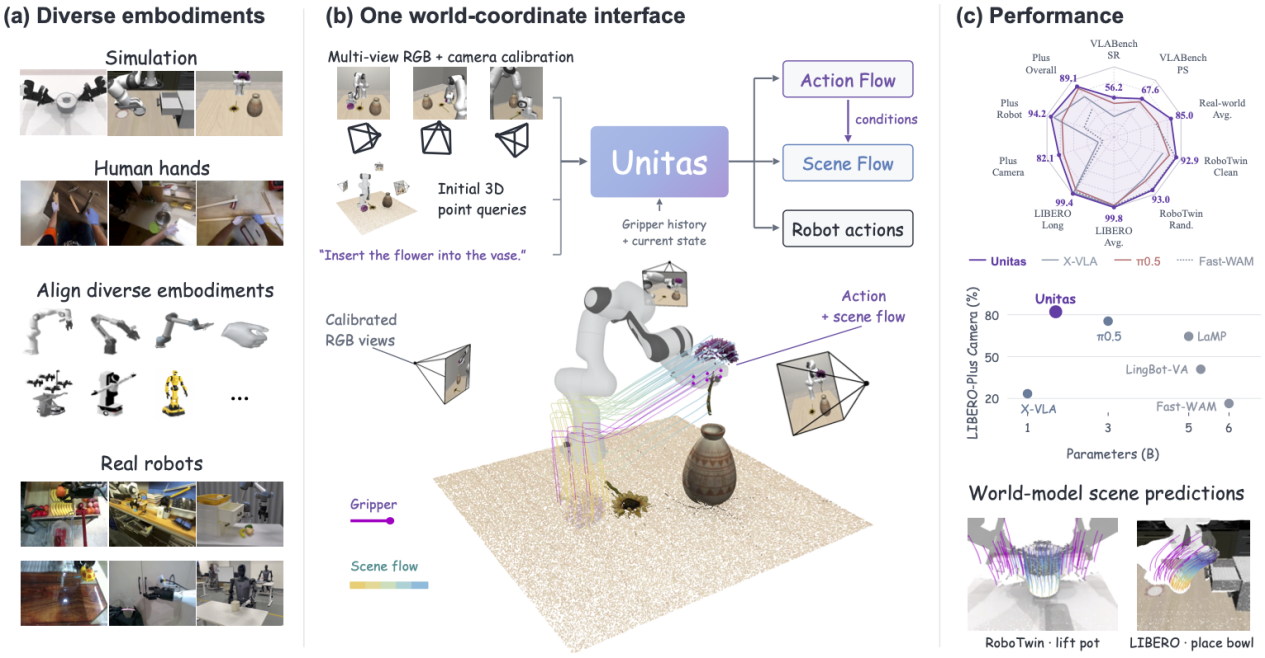
据介绍,UNITAS的核心思路是:让模型直接在三维物理空间中学习,将观察、动作与场景变化统一到同一个三维坐标系中,让机器人不仅学习“如何行动”,也理解“行动之后世界如何变化”。区别于传统方法,UNITAS将三维空间作为模型理解世界的基础表示。通过统一人手、机器人夹爪以及仿真操作数据的表达方式,模型能够从不同来源的物理经验中学习,提升跨场景、跨本体的泛化能力。
在性能表现上,UNITAS展现出“小参数、高能力”的特点。仅凭1.7B(17亿)参数,UNITAS在多项机器人基准测试中取得领先表现,并超过参数规模更大的模型,包括6B参数的Fast-WAM、8B参数的Motus,以及π0.5、LingBot-VA、PointWorld等模型。其中,在LIBERO测试中取得99.8%的平均成功率,在RoboTwin 2.0双臂操作任务中Clean和Randomized设置分别达到92.94%和93.04%。
“UNITAS在真实机器人操作任务中平均成功率达到85%,验证了3D原生世界动作模型从仿真到现实环境的迁移能力。”跨维智能相关负责人表示,从生成式仿真到具身智能模型,再到真实场景应用,我们正在探索Physical AI的发展路径,推动机器人从“执行任务”走向“理解世界”,加速具身智能进入更多生产与生活场景。
(受访方供图)
编辑 张克 审核 谭录岗 郑蔚珩