

人工智能的潜在风险你清楚吗?来听听佛山这场分享课
当前,人工智能技术的快速迭代发展,已成为经济发展的新引擎和国家竞争的新焦点。在促进技术快速发展的同时,如何防范人工智能带来的潜在风险,已成为国际社会的重要关切。
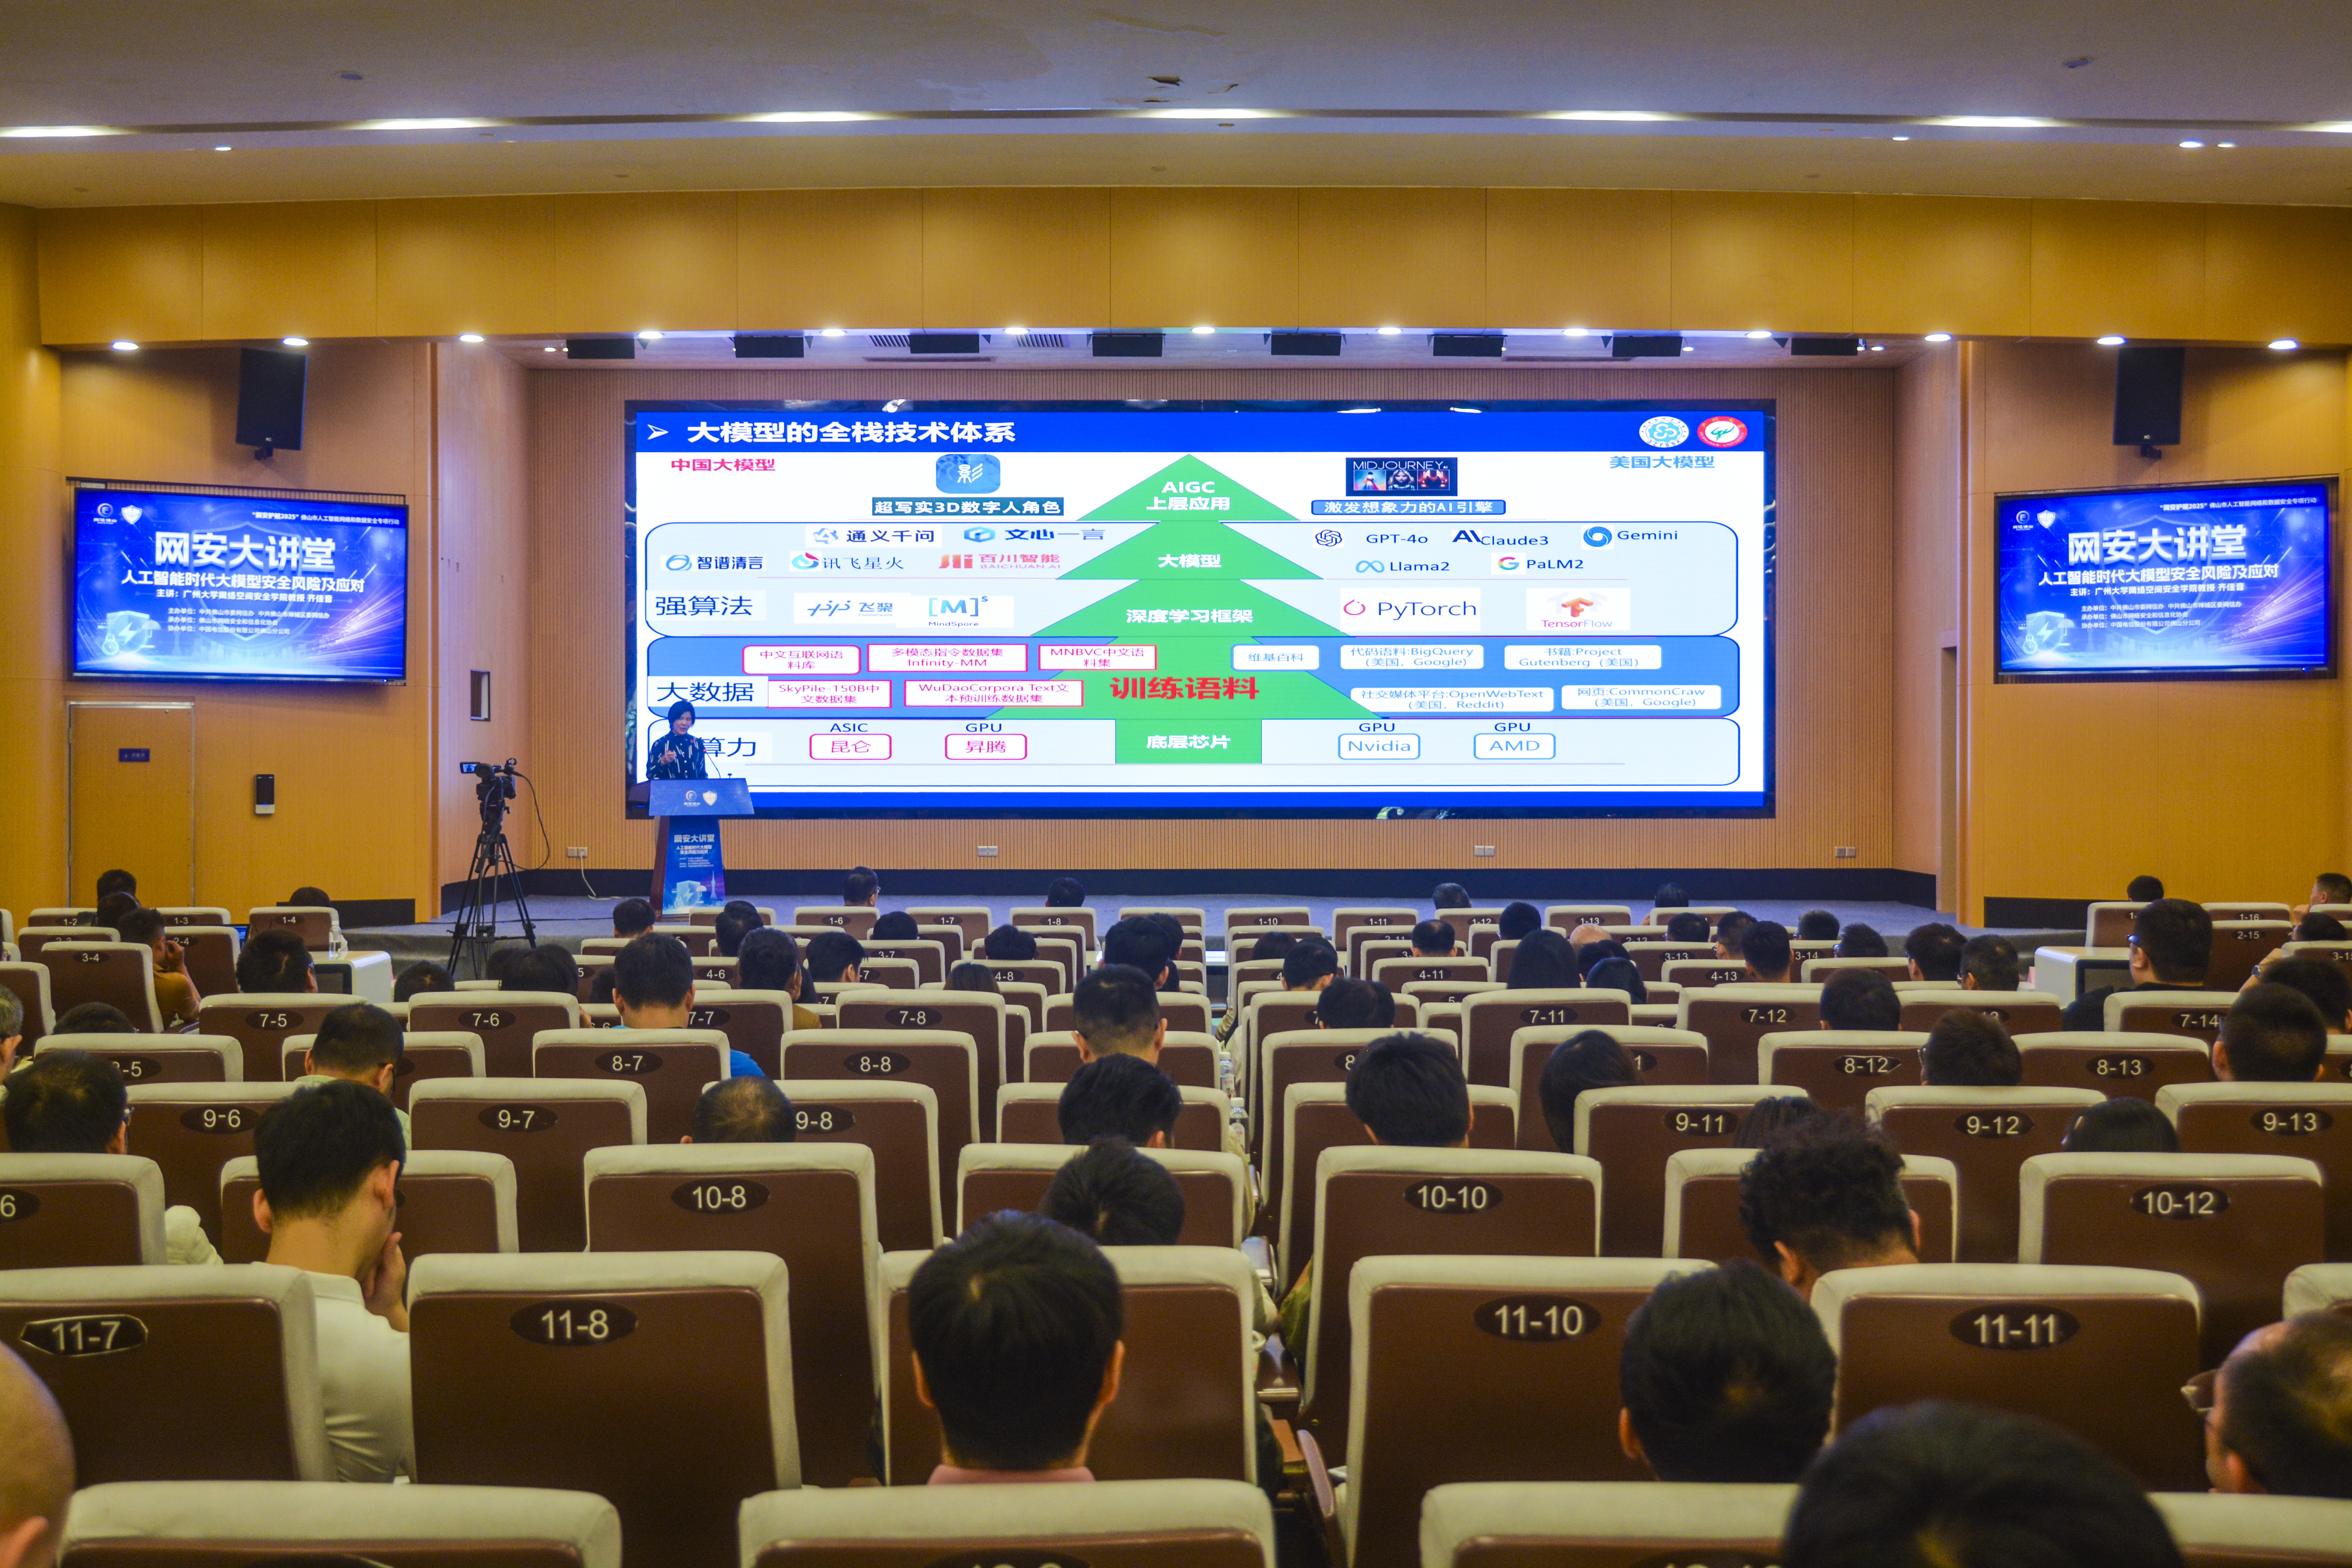
4月15日,正值全民国家安全教育日,由中共佛山市委网信办、中共佛山市禅城区委网信办主办,佛山市网络安全和信息化协会承办,中国电信股份有限公司佛山分公司协办的“网安大讲堂”在文华花市指挥中心开讲,邀请广州大学网络空间安全学院齐佳音教授以《人工智能时代大模型安全风险及应对》为题,分享了人工智能大模型的定义、用途、风险及应对方式,吸引了五区各市直单位负责网络信息安全的技术骨干及市民朋友超3100人次参与学习。
大模型核心是像人类一样选择性关注
开场时,齐佳音首先抛出一个问题:大模型的核心是什么?
她认为,大模型的核心是注意力机制,这好比人类看东西时,会自动把目光聚焦在重要部分,大模型也学会了这招。在处理信息时,它能够精准抓住关键信息,忽略不相关内容,从而提高处理效率及准确性。
不仅如此,大模型根据不同应用领域分类,也发挥着不同的作用,其包括 L0、L1、L2 三个层级。
 图源:齐佳音课件
那么垂直大模型如何形成?就医疗大模型举例来看,训练一个医疗领域的大语言模型,需要先海量收集医学相关数据,再把这些数据“加工”成模型能读懂的格式,接着基于基座模型架构开始训练,最后还得请医疗专家把关,确保在真实医疗场景中真能派上用场。
大模型的“天花板”与潜在风险
如此看来,强大的大模型,是否就完美无缺?
对此,齐佳音引用了中科院院士、清华大学教授张钹的一句话,无论多大模型、多大数据都无法突破三个天花板:“输出质量不可控,生成结果不可信,输出不稳定。”齐佳音还进一步列举了大模型九大风险:文化认知安全风险——该风险会导致特定文化群体的传统认知被颠覆,进而影响文化传承;政治意识形态风险——大模型可能被恶意用户或组织用于政治意识形态领域,从而破坏社会信任;社会偏见歧视风险——比如在大型语言模型的描述中,女性从事家务劳动的频率是男性的4倍;虚假内容传播风险——该风险会扰乱正常的信息传播生态,降低社会整体信任度;隐私或机密泄露风险——比如ChatGPT “奶奶”病毒,爆出Windows序列号;知识产权风险——人工智能生成内容有可能会构成作品侵权;科技伦理风险——大模型可能成为低廉便捷的“科研枪手”;劳动岗位风险——绝大多数职业和从业者将受到GPT冲击;数字不平等风险——巨头垄断下更隐蔽的不平等。
 齐佳音教授。
其中,在劳动岗位风险中,拥有学士、硕士及更高学位的工作者,以及不需要培训或只需实习的职业更容易收到 GPT 冲击;“数据处理、信息处理”深度相关的行业受到GPT影响最大。
此外,大模型也很可能将人带入被动性牢笼,即LLM成瘾(效率成瘾),这来源于人们从突如其来的“能够做得更快、更多”中尝到了“成功”的滋味,而忽视了工作质量、深度以及对个人和社会的长远影响。

谨防大模型重应用、轻安全
面对这些风险,我们该怎么办?
齐佳音表示,目前尚无完美安全的模型,在DeepSeek之后,大模型需要谨防重应用轻安全的问题。
国家也意识到防范人工智能潜在风险的重要性。2024年2月,全国信息安全标准化技术委员会发布《生成式人工智能服务安全基本要求》,明确了生成式人工智能服务在安全方面的基本要求,对其关键词库、生成内容测试题库、拒答测试题库、非拒答测试题库、语料来源、语料内容等方面都提出了相应严格要求,为生成式人工智能服务的安全发展保驾护航。
课堂尾声,齐佳音强调,据大模型之家预测,从2020年到2028年,中国大模型市场规模将从15亿元人民币一路飙升至1179 亿元人民币。这一蓬勃发展的态势,彰显出人工智能技术蕴含的巨大潜力。同时,人工智能的技术之治也同样具有显著的经济价值和社会价值,是中国经验的重要组成部分,对于全球人工智能治理具有重大的借鉴意义。未来,仍需立足全人类的科学发展观,共同做好风险防范。
文、图 | 佛山市新闻传媒中心记者陈宁静